<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>但行好事，莫问前程</title>
  
  <subtitle>Web Developer</subtitle>
  <link href="/atom.xml" rel="self"/>
  
  <link href="http://silencewh.xin/"/>
  <updated>2020-07-02T08:25:13.946Z</updated>
  <id>http://silencewh.xin/</id>
  
  <author>
    <name>silence_wh</name>
    
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title>浏览器工作原理学习笔记(五)-浏览器中的页面</title>
    <link href="http://silencewh.xin/2020/07/03/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E4%BA%94-%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%AD%E7%9A%84%E9%A1%B5%E9%9D%A2/"/>
    <id>http://silencewh.xin/2020/07/03/浏览器工作原理学习笔记-五-浏览器中的页面/</id>
    <published>2020-07-02T16:24:46.000Z</published>
    <updated>2020-07-02T08:25:13.946Z</updated>
    
    <content type="html"><![CDATA[<h2 id="Chrome-DevTools-中的网络面板"><a href="#Chrome-DevTools-中的网络面板" class="headerlink" title="Chrome DevTools 中的网络面板"></a>Chrome DevTools 中的网络面板</h2><p>网络面板中单个请求的时间线：<br><img src="http://img.souche.com/f2e/c6b9c0efb6625848c0adbae1e8842531.jpg" alt="Markdown"></p><a id="more"></a><h3 id="解释"><a href="#解释" class="headerlink" title="解释"></a>解释</h3><ol><li>Queueing（排队时间）：<br>浏览器加载资源是有优先级的（优先加载 HTML、CSS、JS），其他的请求要为这些资源加载”让路“。<br>同时，Chrome 为每个域名维护 6 个 TCP 连接，发起 HTTP 请求时，这几个 TCP 连接都处于忙碌状态，就会处于排队状态。</li><li>Stalled<br>在发起连接之前，有一些其他原因导致推迟，这就是 Stalled 时间。</li><li>Initial connection/SSL<br>和服务器建立连接，包括建立 TCP 连接，以及 HTTPS 协议的 SSL 握手时间。</li><li>Request sent<br>将浏览器缓冲区的数据发送出去。（可以忽略不计）</li><li>Waiting (TTFB)<br>第一字节时间，表示从连接发出去到收到服务器响应的第一字节的消耗时间。表现<strong>服务器响应能力。</strong></li><li>Content Download<br>从第一字节之后，到完整接收服务器响应内容所消耗时间。</li></ol><h3 id="优化"><a href="#优化" class="headerlink" title="优化"></a>优化</h3><ol><li>Queueing（排队时间）过久<br>采用<strong>域名分片技术</strong>（扩充域名）或是升级至 HTTP2 （没有 TCP 连接数的限制了）。</li><li>第一字节时间（TTFB）过久<ul><li>提升服务器的处理速度</li><li>采用 CDN 解决网络延迟</li><li>优化请求头</li></ul></li><li>Content Download 过久<br>减少单个请求的内容大小。</li></ol><h2 id="渲染流程"><a href="#渲染流程" class="headerlink" title="渲染流程"></a>渲染流程</h2><p>渲染流程图（侧重在构建 DOM 树阶段）如下：<br><img src="http://img.souche.com/f2e/e8f016ce97c5822ecd161e2934372ddb.jpg" alt="Markdown"></p><h3 id="DOM-树的构建"><a href="#DOM-树的构建" class="headerlink" title="DOM 树的构建"></a>DOM 树的构建</h3><p>通过网络进程获取到的 HTML 字节流，持续不断地输送给渲染进程的 HTML 解析器：<br><img src="http://img.souche.com/f2e/77028c737c51f664d85d91727b413a3b.jpg" alt="Markdown"></p><ul><li>分词，同时维护一个 Token 的栈，用来辅助 DOM 树的生成</li><li>构建 DOM 树</li></ul><h4 id="影响-DOM-构建的因素"><a href="#影响-DOM-构建的因素" class="headerlink" title="影响 DOM 构建的因素"></a>影响 DOM 构建的因素</h4><ol><li>遇到内联的 script 标签，需要停止 DOM 的构建，等到 JS 执行完再继续；遇到需要加载外部 script 的文件，需要先下载，再执行；</li><li>如果页面中有引入外部的 CSS 文件，同时又引入了外部的 JS 的文件，需要先下载 CSS 文件，再构建 CSSOM，然后才能执行 JS 文件；</li><li>Chrome 会在 HTML 数据响应之后，开启一个预解析线程，用来下载 HTML 文件中的 CSS 和 JS 文件；</li></ol><h4 id="页面白屏时间"><a href="#页面白屏时间" class="headerlink" title="页面白屏时间"></a>页面白屏时间</h4><ol><li>输入 URL 到网络进程响应内容<blockquote><p>这一阶段主要受网络和服务器的影响较大</p></blockquote></li><li>JS 执行阻塞 DOM 的构建<blockquote><p>这一阶段主要是因为 CSS 和 JS 文件的下载，以及 JS 文件的执行</p></blockquote></li></ol><h4 id="如何减少页面白屏时间（第二个）"><a href="#如何减少页面白屏时间（第二个）" class="headerlink" title="如何减少页面白屏时间（第二个）"></a>如何减少页面白屏时间（第二个）</h4><ul><li>将 CSS 和 JS 内联，排除文件的下载时间干扰。但是这样的做法只适用于部分场景，因为内联会导致 HTML 的体积变大，增加第一个白屏时间</li><li>通过 webpack 打包工具，减小 CSS 和 JS 文件体积大小，主要做法是压缩和去除注释</li><li>将首屏不需要的 JS 文件，标记上 async 或 defer，使他们不阻塞 DOM 的构建</li><li>将 CSS 文件按照不同的场景进行拆分，避免首次全量加载</li></ul><h3 id="渲染引擎的分层和合成机制"><a href="#渲染引擎的分层和合成机制" class="headerlink" title="渲染引擎的分层和合成机制"></a>渲染引擎的分层和合成机制</h3><p>为了提升渲染的效率，浏览器中的页面会分成很多个”层“，类似于 PS 中的图层。合成操作是将这些图层合并到一起。<br>分层是在布局树构建之后，渲染引擎会根据布局树的特点将其转换为层树，层树是渲染流水线后续流程的基础。<br>合成操作是在合成线程中进行的，不会影响到主线程。所以有时候主线程卡住了，但是 CSS 动画依然能够执行。</p><h4 id="利用分层技术优化代码"><a href="#利用分层技术优化代码" class="headerlink" title="利用分层技术优化代码"></a>利用分层技术优化代码</h4><p>如果用 JS 来实现动画的话，会牵扯到整个渲染流程，效率十分低下。可以利用分层机制来优化动画的实现：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">.box &#123;</span><br><span class="line">will-change: transform, opacity;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>使用 will-change 来提前申明会对该元素做哪些操作。渲染引擎会将该元素单独实现一层，等变换发生时，通过合成线程去处理变换，没有涉及到主线程，大大提升了渲染效率。</p><h2 id="如何系统的优化页面"><a href="#如何系统的优化页面" class="headerlink" title="如何系统的优化页面"></a>如何系统的优化页面</h2><p>主要是优化处在<strong>加载阶段</strong>和<strong>交互阶段</strong>的页面。</p><h3 id="加载阶段"><a href="#加载阶段" class="headerlink" title="加载阶段"></a>加载阶段</h3><ul><li>减少关键资源的个数</li><li>缩小关键资源的体积<blockquote><p>关键资源指的是影响首屏加载的各类资源（HTML、CSS 文件）。<br>通过以上两个方法，来减少关键资源的 RTT 时间。</p></blockquote></li></ul><h3 id="交互阶段"><a href="#交互阶段" class="headerlink" title="交互阶段"></a>交互阶段</h3><ul><li>减少 JS 的执行时间<blockquote><p>通过函数任务的切分，让脚本不要一次霸占主线程太长时间</p></blockquote></li><li>避免强制同步布局和布局抖动<blockquote><p>避免将计算样式和布局操作提前到当前任务当中，主要是由修改完 DOM 之后立即查询 DOM 属性导致的。布局抖动指的是，在一段 JS 代码执行过程中，反复执行布局操作。不过目前使用现代的前端框架（React、Vue 等），已经避免了这样的问题。</p></blockquote></li><li>合理利用 CSS 合成动画<blockquote><p>因为合成动画是在合成线程上执行的，不会占用主线程，而且合成线程合成动画的效率很高。</p></blockquote></li><li>避免频繁的垃圾回收<blockquote><p>减少临时对象的创建，避免小颗粒对象的产生。</p></blockquote></li></ul>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;Chrome-DevTools-中的网络面板&quot;&gt;&lt;a href=&quot;#Chrome-DevTools-中的网络面板&quot; class=&quot;headerlink&quot; title=&quot;Chrome DevTools 中的网络面板&quot;&gt;&lt;/a&gt;Chrome DevTools 中的网络面板&lt;/h2&gt;&lt;p&gt;网络面板中单个请求的时间线：&lt;br&gt;&lt;img src=&quot;http://img.souche.com/f2e/c6b9c0efb6625848c0adbae1e8842531.jpg&quot; alt=&quot;Markdown&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>浏览器工作原理学习笔记(六)-浏览器中的网络</title>
    <link href="http://silencewh.xin/2020/07/02/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E5%85%AD-%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%AD%E7%9A%84%E7%BD%91%E7%BB%9C/"/>
    <id>http://silencewh.xin/2020/07/02/浏览器工作原理学习笔记-六-浏览器中的网络/</id>
    <published>2020-07-02T15:53:30.000Z</published>
    <updated>2020-07-02T07:59:00.974Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>本系列为极客时间上的<a href="https://time.geekbang.org/column/intro/216" target="_blank" rel="noopener">《浏览器工作原理与实践》</a>专栏的学习笔记</p></blockquote><h2 id="历史发展"><a href="#历史发展" class="headerlink" title="历史发展"></a>历史发展</h2><p>HTTP 最早的一个版本是 HTTP/0.9 ，主要是为了学术交流的需求，因此设计的比较简单，没有请求头和响应头，也只能支持一种文件类型（html）的传输。</p><a id="more"></a><p>随着浏览器的推出，通过网络浏览各种文件的需求越来越多，因此就有了 HTTP/1.0 的推出，主要解决的是各种类型文件的下载问题，主要是通过增加请求头和响应头来解决，具体是：</p><ul><li>文件类型</li><li>文件的压缩方法</li><li>文件的语言类型</li><li>文件的编码方式</li></ul><p>随着技术的继续发展，需求也在迭代更新，新版本 HTTP/1.1 做了大量的优化工作，核心有以下几点：</p><ul><li>增加持久连接（默认开启）。在一个 TCP 连接上传输多个 HTTP 请求</li><li>提供虚拟主机的支持。支持一台服务器可以提供多个域名，但是最终指向的是同一个 IP，所以请求头 需要增加字段 HOST 来表明该请求对应的哪个域名</li><li>客户端 Cookie、安全机制</li></ul><h2 id="解决问题"><a href="#解决问题" class="headerlink" title="解决问题"></a>解决问题</h2><p>HTTP/1.1 存在的一些问题：</p><ul><li>TCP 的慢启动</li><li>多条 TCP 连接存在带宽竞争的问题</li><li>HTTP/1.1 队头阻塞。一个 TCP 管道同一时刻只能处理一个请求，如果某个请求处理时间多长，就会导致其他请求处于等待过程</li></ul><p>HTTP/2 的推出，主要是通过一个域名下只维持一个 TCP 连接和消除队头阻塞，来解决遗留问题。核心是通过多路复用技术来解决了 HTTP/1.1 的队头阻塞问题。</p><h3 id="HTTP-2-的多路复用"><a href="#HTTP-2-的多路复用" class="headerlink" title="HTTP/2 的多路复用"></a>HTTP/2 的多路复用</h3><p>HTTP/2 协议栈新增了一个二进制分帧层，来将各个请求数据转换为一个个带有请求 ID 编号的帧，通过协议栈发送给服务器。</p><p>服务器和浏览器，通过请求 ID 来将这些帧还原成一个个请求数据，继续处理。这样做的好处是，浏览器可以随时发送不同的请求，不用再等待上一个请求处理完成，也就解决了 HTTP/1.1 的队头阻塞问题。</p><p>同时还有其他的一些优点：</p><ul><li>可以设置请求的优先级</li><li>服务器推送</li><li>头部压缩</li></ul><p>虽然 HTTP/2 引入一个二进制分帧层，但是语义和 HTTP/1.1 是一样的，也就是通信语言没有改变，变的是传输方式。这样对于开发人员是比较友好的，部署起来也比较简单，这也是 HTTP/2 能够更快的推广的原因。</p><h3 id="HTTP-3"><a href="#HTTP-3" class="headerlink" title="HTTP/3"></a>HTTP/3</h3><p>即使 HTTP/2 通过多路复用解决了 HTTP/1.1 的队头阻塞问题，但是底层上还是基于 TCP 协议，因此就有一个问题绕不开：</p><p>TCP 为了保证数据传输的可靠性，对于丢失的数据包会有重传机制，这就会导致其他数据包在重传时期无法得到处理，造成 TCP 队头阻塞。</p><p>除了 TCP 队头阻塞，较长的握手时间也会导致网络延迟的增加。</p><p>为了解决这些问题，同时也不能抛开 TCP （难度与成本太大），只能是引入一个新的协议：QUIC，这个协议集合了以下几点功能：</p><ul><li>实现了 TCP 的流量控制和传输可靠性</li><li>集成了 TLS 的加密功能</li><li>实现了 HTTP/2 的多路复用<br>在同一个物理连接上有多个独立的逻辑数据流，实现数据流的单独传输，解决了 TCP 的队头阻塞问题</li><li>实现了快速握手的功能</li></ul><p>虽然 HTTP/3 有很多优点，但是由于动了底层协议，推广起来有来自各方面的挑战，等到最后大规模部署和优化会是一个比较缓慢的过程。</p>]]></content>
    
    <summary type="html">
    
      &lt;blockquote&gt;
&lt;p&gt;本系列为极客时间上的&lt;a href=&quot;https://time.geekbang.org/column/intro/216&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;《浏览器工作原理与实践》&lt;/a&gt;专栏的学习笔记&lt;/p&gt;
&lt;/blockquote&gt;
&lt;h2 id=&quot;历史发展&quot;&gt;&lt;a href=&quot;#历史发展&quot; class=&quot;headerlink&quot; title=&quot;历史发展&quot;&gt;&lt;/a&gt;历史发展&lt;/h2&gt;&lt;p&gt;HTTP 最早的一个版本是 HTTP/0.9 ，主要是为了学术交流的需求，因此设计的比较简单，没有请求头和响应头，也只能支持一种文件类型（html）的传输。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>浏览器工作原理学习笔记(四)-浏览器中的JS执行机制</title>
    <link href="http://silencewh.xin/2020/06/06/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E5%9B%9B-%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%AD%E7%9A%84JS%E6%89%A7%E8%A1%8C%E6%9C%BA%E5%88%B6/"/>
    <id>http://silencewh.xin/2020/06/06/浏览器工作原理学习笔记-四-浏览器中的JS执行机制/</id>
    <published>2020-06-05T18:37:07.000Z</published>
    <updated>2020-07-02T07:58:50.410Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>本系列为极客时间上的<a href="https://time.geekbang.org/column/intro/216" target="_blank" rel="noopener">《浏览器工作原理与实践》</a>专栏的学习笔记</p></blockquote><h2 id="变量提升"><a href="#变量提升" class="headerlink" title="变量提升"></a>变量提升</h2><p>JS 引擎在执行一段 JS 代码的时候，流程如下：<br><img src="http://img.souche.com/f2e/18b7ef1f7763f46f192e34b23837d7ce.jpg" alt="Markdown"></p><a id="more"></a><p>在编译阶段，主要做了以下这些事情：</p><ul><li>产生可执行代码和执行上下文</li><li>执行上下文包含：变量环境和词法环境，变量环境里面保存着该段代码需要的变量和函数</li><li>遇到声明语句，将对应的变量或函数保存在执行上下文的变量环境中，并赋予变量默认值，函数的值为指针，指向堆中保存函数体的地址</li><li>将可执行代码编译成字节码</li></ul><p>编译阶段在遇到同名变量或函数的时候，后者会覆盖前者。<br>执行阶段就是按顺序，一行一行执行可执行代码。</p><h2 id="调用栈"><a href="#调用栈" class="headerlink" title="调用栈"></a>调用栈</h2><p>调用栈是 JS 引擎用来管理执行上下文的数据结构。<br>在一个页面中，会存在一个全局上下文和若干个函数执行上下文。在执行代码的过程中，遇到函数调用，会先对函数代码进行编译，形成函数执行上下文，并将其压入栈中。待函数执行完成之后，会有一个出栈的操作，用来销毁掉当前的函数执行上下文。</p><h3 id="栈溢出"><a href="#栈溢出" class="headerlink" title="栈溢出"></a>栈溢出</h3><p>调用栈是有容量大小的，当入栈的执行上下文超过一定数量时，JS 引擎就会报错，这种错误就是栈溢出。在一些函数递归调用的场景中，如果没有设置合理的退出条件，就会发生栈溢出的错误。可以通过使用加入定时器的方法，来把当前任务拆分成许多小任务，来解决这种问题。</p><h2 id="块级作用域"><a href="#块级作用域" class="headerlink" title="块级作用域"></a>块级作用域</h2><p>在 ES6 之前，JS 的作用域只有两种：全局作用域和函数作用域。由于没有块级作用域，JS 引擎在编译代码的时候，会执行变量提升，由此带来的问题是： - 变量覆盖 - 变量没有被及时销毁<br>ES6 通过引入 let 和 const 关键字，支持了块级作用域，同时还向下兼容着变量提升的特性。在编译阶段，let 和 const 关键字声明的变量会被存放在执行上下文中的词法环境里，而且块与块之间互不影响（是一个栈的结构）。<br>值得注意的是，在块级作用域中，在 let 或 const 声明语句之前去使用它们定义的变量，会报错，因为这些变量即使存放在词法环境里，但是并没有被初始化，也就形成了所谓的”暂时性死区“。所以一个比较好的习惯时，如果逻辑不是很复杂，建议将变量声明都放在最前面。</p><h2 id="作用域链和闭包"><a href="#作用域链和闭包" class="headerlink" title="作用域链和闭包"></a>作用域链和闭包</h2><p>JS 引擎在执行过程中，为了查找某个变量的值，是依照作用域链来查找的。作用域链的形成由词法作用域所决定，后者是由代码的书写结构所决定的，也就是说，词法作用域是静态的作用域。<br>在每个执行上下文的变量环境中，都存在一个指向外部执行上下文的引用，称为 outer。在查找变量的过程中，outer 起到了路径引导作用。<br>示例代码：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">function bar() &#123;</span><br><span class="line">    console.log(myName)</span><br><span class="line">&#125;</span><br><span class="line">function foo() &#123;</span><br><span class="line">    var myName = &quot;极客邦&quot;</span><br><span class="line">    bar()</span><br><span class="line">&#125;</span><br><span class="line">var myName = &quot;极客时间&quot;</span><br><span class="line">foo()</span><br></pre></td></tr></table></figure><p>执行 bar 函数时的调用栈：<br><img src="http://img.souche.com/f2e/72ab6a43fac9dad1372b17d42a257d97.jpg" alt="Markdown"></p><h3 id="闭包"><a href="#闭包" class="headerlink" title="闭包"></a>闭包</h3><p>闭包的形成：一个函数最终返回了一个内部函数，并且该内部函数引用到了外部函数里面的变量。即使外部函数执行完之后被销毁了，但是被内部函数引用到的变量保存下来了，存在的结构就称为“闭包”，可以理解为是内部函数的“专属背包”。<br>在之后的内部函数执行过程中，查找变量的作用链中就会包含闭包这个节点。</p><h2 id="JS-中的-this"><a href="#JS-中的-this" class="headerlink" title="JS 中的 this"></a>JS 中的 this</h2><p>首先需要明确的是 this 保存在执行上下文中。<br>JS 中存在三种执行上下文：全局执行上下文、函数执行上下文、eval 执行上下文。eval 不经常用，可以忽略，所以只需要关注在全局和函数执行上下文中，this 指向何处就好了。</p><ol><li>全局执行上下文的 this 指向 window （浏览器环境，非严格模式）。严格模式下指向的是 undefined。</li><li>函数执行上下文的 this 指向<ul><li>默认指向，指向 window （非严格模式），严格模式下指向 undefined</li><li>作为对象的方法被执行，指向该对象</li><li>作为构造函数被执行，指向新 new 出来的对象</li><li>使用 call/apply/bind 方法时，指向指定的参数</li></ul></li></ol><h3 id="this-的设计缺陷以及应对方案"><a href="#this-的设计缺陷以及应对方案" class="headerlink" title="this 的设计缺陷以及应对方案"></a>this 的设计缺陷以及应对方案</h3><ol><li>嵌套函数中的 this 不会从外部继承<blockquote><p>解决方案：<br>将外部函数的 this 传入给内部函数；<br>使用箭头函数；</p></blockquote></li><li>普通函数中的 this 默认指向全局对象<blockquote><p>解决方案：<br>通过 call/apply/bind 函数调用，避免打破数据的边界；<br>设置严格模式，将 bug 的出现时机前置；</p></blockquote></li></ol>]]></content>
    
    <summary type="html">
    
      &lt;blockquote&gt;
&lt;p&gt;本系列为极客时间上的&lt;a href=&quot;https://time.geekbang.org/column/intro/216&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;《浏览器工作原理与实践》&lt;/a&gt;专栏的学习笔记&lt;/p&gt;
&lt;/blockquote&gt;
&lt;h2 id=&quot;变量提升&quot;&gt;&lt;a href=&quot;#变量提升&quot; class=&quot;headerlink&quot; title=&quot;变量提升&quot;&gt;&lt;/a&gt;变量提升&lt;/h2&gt;&lt;p&gt;JS 引擎在执行一段 JS 代码的时候，流程如下：&lt;br&gt;&lt;img src=&quot;http://img.souche.com/f2e/18b7ef1f7763f46f192e34b23837d7ce.jpg&quot; alt=&quot;Markdown&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>Vue插件开发小记</title>
    <link href="http://silencewh.xin/2020/03/26/Vue%E6%8F%92%E4%BB%B6%E5%BC%80%E5%8F%91%E5%B0%8F%E8%AE%B0/"/>
    <id>http://silencewh.xin/2020/03/26/Vue插件开发小记/</id>
    <published>2020-03-25T18:10:24.000Z</published>
    <updated>2020-03-25T10:10:24.766Z</updated>
    
    <content type="html"><![CDATA[<h2 id="背景"><a href="#背景" class="headerlink" title="背景"></a>背景</h2><p>公司有统一的微信公众号登录服务，需要给前端封装此功能，以便各项目使用。由于公司移动端项目采用的 Vue 技术栈，所以决定将微信公众号登录的功能以 Vue 插件的形式提供出去。<br>将开发过程中一些值得记录的点记下来，此功能实现的代码很简单，就不放出来了。<br>假设该插件的名字是 vue-wx-login。</p><a id="more"></a><h2 id="初始化项目"><a href="#初始化项目" class="headerlink" title="初始化项目"></a>初始化项目</h2><p>通过 <a href="https://cli.vuejs.org/zh/" target="_blank" rel="noopener">Vue CLI</a> 脚手架搭建项目：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">vue create vue-wx-login</span><br><span class="line">cd vue-wx-login</span><br><span class="line">yarn</span><br></pre></td></tr></table></figure><p>以上操作会在本地新建一个名叫 vue-wx-login 的文件夹。</p><h2 id="模块配置"><a href="#模块配置" class="headerlink" title="模块配置"></a>模块配置</h2><p>由于模块最终目的是要导出 Vue 插件，因此需要更改一下<a href="https://cli.vuejs.org/zh/guide/build-targets.html" target="_blank" rel="noopener">构建目标 | Vue CLI</a>。同时，要指定正确的<a href="https://docs.npmjs.com/files/package.json#main" target="_blank" rel="noopener">模块入口</a>。<br>package.json 作出如下修改：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">&#123;</span><br><span class="line">“scripts”: &#123;</span><br><span class="line">  “build”: “cross-env NODE_ENV=production vue-cli-service build --target lib --name wxLogin ./src/index.js&quot;</span><br><span class="line">&#125;,</span><br><span class="line">“main”: “dist/wxLogin.common.js”</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><code>--name wxLogin ./src/index.js</code><br>指定模块名称，以及构建时的入口文件。</p><p><code>“main”: “dist/wxLogin.common.js”</code><br>vue-cli 的构建产物文件夹默认是 dist ，可通过 vue.config.js 更改。这里指定模块的入口文件是一个给打包器用的 CommonJS 包。</p><hr><p>根据<a href="https://cli.vuejs.org/zh/guide/build-targets.html#vue-vs-js-ts-%E5%85%A5%E5%8F%A3%E6%96%87%E4%BB%B6" target="_blank" rel="noopener"><strong>Vue vs. JS/TS 入口文件</strong></a>文档，由于我们将 .js 文件作为入口文件，并且没有任何具名导出，同时希望直接暴露默认导出。<br>需要在 vue.config.js 中添加以下 webpack 配置。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">module.exports = &#123;</span><br><span class="line">configureWebpack: &#123;</span><br><span class="line">    output: &#123;</span><br><span class="line">      libraryExport: ‘default’</span><br><span class="line">    &#125;</span><br><span class="line">  &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h2 id="本地调试"><a href="#本地调试" class="headerlink" title="本地调试"></a>本地调试</h2><p>开发 npm 模块的时候，除了在模块本身的工程内进行调试，还有一个更重要的调试环节就是在真实的项目中进行引用和调试。<br>比较笨的方法是模块更改一次便重新发布，然后项目更新模块版本。这种办法除了比较蠢以外，还有以下缺点： - 手动操作，耗时费力 - 模块增加了很多垃圾版本号<br>npm 官方针对该问题，提供了<a href="https://docs.npmjs.com/cli/link.html" target="_blank" rel="noopener">npm link 解决方案</a>。<br>非常简单，只需要两个步骤：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">// 进入模块文件夹</span><br><span class="line">cd vue-wx-login</span><br><span class="line">npm link</span><br><span class="line">// 进入项目文件夹</span><br><span class="line">cd your-project</span><br><span class="line">npm link vue-wx-login</span><br></pre></td></tr></table></figure><p><strong>注意：npm link vue-wx-login 这里 link 的是模块名称，也就是 package.json 中的 name 字段的值，而不是模块的文件夹名称。</strong><br>也可以简化为一个步骤：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">cd your-project</span><br><span class="line">npm link path/to/vue-wx-login</span><br></pre></td></tr></table></figure><p><strong>这种方式 link 的是模块的相对路径，而不是包名称</strong></p><blockquote><p>在调试过程中，可以先将模块的 main 字段改为 ./src/index.js ，而不是打包之后的入口。这么做的好处是，可以在模块修改之后，实时映射到项目文件夹。否则，每次模块改动都需要构建。<br>经过以上步骤之后，项目中就增加了该模块的依赖，可以正常引用该模块了。</p></blockquote><h2 id="发布模块"><a href="#发布模块" class="headerlink" title="发布模块"></a>发布模块</h2><p>调试没问题之后，准备发布模块至 npm 。</p><h3 id="npm-unlink"><a href="#npm-unlink" class="headerlink" title="npm unlink"></a>npm unlink</h3><p>在发布模块之前，首先要先将之前通过 npm link 创建的链接解除：<br>第一步：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">cd your-project</span><br><span class="line">npm unlink —no-save &lt;module_name&gt;</span><br></pre></td></tr></table></figure><p>第二步：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">cd vue-wx-login</span><br><span class="line">npm unlink</span><br></pre></td></tr></table></figure><h3 id="发布"><a href="#发布" class="headerlink" title="发布"></a>发布</h3><p>首先将 package.json 中的 main 字段恢复成 dist/wxLogin.common.js。<br>然后在 package.json 的 scripts 字段增加一个命令：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">“prepublishOnly”: “npm run build”</span><br></pre></td></tr></table></figure><p>意思是在模块发布之前，执行构建命令。<a href="https://docs.npmjs.com/misc/scripts" target="_blank" rel="noopener">参照该文档</a><br>如果需要将模块发布至公司私有仓库，执行以下几个步骤： - 设置仓库地址：npm config set registry <a href="https://xxxx.xxx.xxx" target="_blank" rel="noopener">https://xxxx.xxx.xxx</a> - npm login ，根据提示完成登录 - 更改模块名称，增加公司约定的 scope。<a href="https://docs.npmjs.com/using-npm/scope.html" target="_blank" rel="noopener">参照该文档</a><br>发布模块： 1. 更改版本号 2. 执行发布命令：npm publish<br>至此，模块就发布成功了 👏👏。</p><h2 id="参考文档"><a href="#参考文档" class="headerlink" title="参考文档"></a>参考文档</h2><ol><li><a href="https://docs.npmjs.com/cli/link.html" target="_blank" rel="noopener">npm-link | npm Documentation</a></li><li><a href="https://medium.com/@alexishevia/the-magic-behind-npm-link-d94dcb3a81af" target="_blank" rel="noopener">The magic behind npm link</a></li><li><a href="https://cn.vuejs.org/v2/guide/plugins.html" target="_blank" rel="noopener">Vue.js 文档：插件</a></li><li><a href="https://cli.vuejs.org/zh/guide/build-targets.html#%E5%BA%94%E7%94%A8" target="_blank" rel="noopener">构建目标 | Vue CLI</a></li></ol>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;背景&quot;&gt;&lt;a href=&quot;#背景&quot; class=&quot;headerlink&quot; title=&quot;背景&quot;&gt;&lt;/a&gt;背景&lt;/h2&gt;&lt;p&gt;公司有统一的微信公众号登录服务，需要给前端封装此功能，以便各项目使用。由于公司移动端项目采用的 Vue 技术栈，所以决定将微信公众号登录的功能以 Vue 插件的形式提供出去。&lt;br&gt;将开发过程中一些值得记录的点记下来，此功能实现的代码很简单，就不放出来了。&lt;br&gt;假设该插件的名字是 vue-wx-login。&lt;/p&gt;
    
    </summary>
    
    
      <category term="Vue.js" scheme="http://silencewh.xin/tags/Vue-js/"/>
    
  </entry>
  
  <entry>
    <title>浏览器工作原理学习笔记(三)-页面循环系统</title>
    <link href="http://silencewh.xin/2020/01/22/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E4%B8%89-%E9%A1%B5%E9%9D%A2%E5%BE%AA%E7%8E%AF%E7%B3%BB%E7%BB%9F/"/>
    <id>http://silencewh.xin/2020/01/22/浏览器工作原理学习笔记-三-页面循环系统/</id>
    <published>2020-01-21T17:25:59.000Z</published>
    <updated>2020-01-21T09:25:59.879Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>本系列为极客时间上的<a href="https://time.geekbang.org/column/intro/216" target="_blank" rel="noopener">《浏览器工作原理与实践》</a>专栏的学习笔记</p></blockquote><h2 id="消息队列和事件循环"><a href="#消息队列和事件循环" class="headerlink" title="消息队列和事件循环"></a>消息队列和事件循环</h2><p>每个渲染进程都会有一个主线程，用来处理各种任务：解析 DOM、执行 JavaScript、响应用户的交互事件、执行动画等。如果要有序的处理这些任务，就必须有一个专门的调度系统来协调，在浏览器中，这个调度系统就是消息队列和事件循环。</p><a id="more"></a><p>主要的执行原理是这样的：主线程维护一个循环程序，这个程序主要做两件事：</p><ol><li><p>从消息队列中取任务（task）</p></li><li><p>执行任务（task）</p></li></ol><p>也就是说，主线程的任务全部来自于消息队列，这个队列是一个数据结构，符合先进先出的特性。刚刚列举的那些任务，很多来自于 IO 线程，都要先 push 到消息队列中。</p><p>那如果是其他进程（比如网络进程、浏览器进程）想要让渲染主线程执行任务呢？</p><p>其他进程的任务会先发送给渲染进程中的 IO 线程，接收到消息之后，再组装成任务发送到消息队列。</p><p>当页面主线程执行完成之后，又该如何保证页面主线程能够安全退出呢？</p><p>Chrome 是这样解决的，确定要退出当前页面时，页面主线程会设置一个退出标志的变量，在每次执行完一个任务时，判断是否有设置退出标志。如果设置了，那么就直接中断当前的所有任务，退出线程。</p><h3 id="缺点"><a href="#缺点" class="headerlink" title="缺点"></a>缺点</h3><p>使用该模型处理任务的缺点有以下两点：</p><ul><li>无法处理优先级更高的任务</li><li>无法解决单个任务执行时间过长的问题</li></ul><p>无法处理优先级更高的任务：</p><p>因为所有的任务都是放在消息队列中，遵从先进先出的规则，即使放入一个优先级更高的任务，也会因为前面排队多个任务而延迟执行。</p><p>解决办法是引入了宏任务和微任务的概念。每一个宏任务都会有一个微任务列表，当前宏任务执行完成之后，并不会着急执行下一个宏任务，而是先检查一下微任务列表，如果有微任务的话，优先执行微任务。所以，对于一些优先级更高的任务，可以放到当前执行宏任务的微任务列表中。</p><p>无法解决单个任务执行时间过长的问题：</p><p>一是从应用程序的角度去解决，尽量避免单个计算量比较大，耗时长的任务。<br>二是可以通过回调功能来规避这种问题，也就是让要执行的 JavaScript 任务滞后执行。</p><h2 id="WebAPI"><a href="#WebAPI" class="headerlink" title="WebAPI"></a>WebAPI</h2><p>事件循环的典型应用就是一些 WebAPI 的实现，主要介绍 setTimeout 和 XMLHttpRequest 的实现。</p><h3 id="setTimeout"><a href="#setTimeout" class="headerlink" title="setTimeout"></a>setTimeout</h3><p>setTimeout 是一个定时器，用来指定某个函数在多少毫秒之后执行。它会返回一个编号，通过这个编号可以取消这个定时器。</p><p>事件循环中的消息队列是按照顺序执行的，因此，setTimeout 产生的任务不能直接放到消息队列中。Chrome 为了维护定时器和内部一些需要延迟执行的任务，定义了一个延迟执行队列。</p><p>为了执行延迟队列中的任务，事件循环程序从消息队列中拿出一个任务并执行后，会去拿延迟队列中的任务。延迟队列任务取出规则是：根据延迟任务的发起时间和延迟时间计算出到期时间，取出到期任务依次执行。</p><p>调用 clearTimeout(timer_id) 可以取消某个定时任务，内部实现也很简单。通过 timer_id 在延迟队列中查找到对应的任务，将其删掉就好了。</p><p>需要注意的点：</p><ul><li>如果定时器被嵌套调用 5 次以上，系统会判断该函数方法被阻塞了，如果调用时间间隔小于 4 毫秒，会被设置成 4 毫秒。所以一些实时性较高的需求就不适合用 setTimeout 了</li><li>未激活的页面，setTimeout 执行最小间隔是 1000 毫秒。这个主要是为了降低损耗</li><li>延时执行时间有最大值，大于 2147483647 毫秒时，会发生溢出，相当于延时值被设置为 0 了</li><li>setTimeout 执行的回调函数，this 指向的是全局环境，严格模式下是 undefined</li></ul><h3 id="XMLHttpRequest"><a href="#XMLHttpRequest" class="headerlink" title="XMLHttpRequest"></a>XMLHttpRequest</h3><p>补充说明：当循环系统在执行一个任务的时候，都要为这个任务维护一个系统调用栈。这个系统调用栈类似于 JavaScript 的调用栈，只不过系统调用栈是 Chromium 的开发语言 C++ 来维护的。</p><p>以下是 XMLHttpRequest 工作流程图：</p><p><img src="http://i1.fuimg.com/706472/5670b67c903e41fa.png" alt="Markdown"></p><p>主要的流程如下：</p><p>渲染进程会将请求发送给网络进程，然后网络进程负责资源的下载，等网络进程接收到数据之后，就会利用 IPC 来通知渲染进程；渲染进程接收到消息之后，会将 xhr 的回调函数封装成任务并添加到消息队列中，等主线程循环系统执行到该任务的时候，就会根据相关的状态来调用 xhr 注册的回调函数。</p><h2 id="宏任务和微任务"><a href="#宏任务和微任务" class="headerlink" title="宏任务和微任务"></a>宏任务和微任务</h2><p>宏任务指的是消息队列中任务，比如：解析 HTML、执行 JavaScript 、用户交互事件等。</p><p>因为开发者无法控制消息队列中任务的添加时间和执行时间，所以对于一些实时性要求较高的应用来说，宏任务就没有办法满足需求了。而且在执行任务的过程中，中间也有可能会插入其他的一些任务，打乱了开发者的控制流程。</p><p>为了解决这个问题，引入了微任务。那么什么是微任务？</p><p>微任务就是一个需要异步执行的函数，执行时机是在主函数执行结束之后、当前宏任务结束之前。具体一点讲就是：V8 引擎在执行 JS 脚本的时候，会创建一个全局执行上下文，同时也会在内部创建一个微任务队列（开发者通过 JS 访问不到）。在当前宏任务执行的过程中产生的微任务，都会加入到这个微任务队列中。在当前宏任务中的 JS 快要执行完成时，V8 引擎会检查微任务队列，按照顺序去执行队列中的微任务。同时，在执行微任务的过程中如果又产生了微任务，也会添加到当前的微任务队列中。</p><p>那么，怎样会产生微任务？</p><ul><li>使用 MutationObserver 监控某个 DOM 节点，然后再通过 JavaScript 来修改这个节点，或者为这个节点添加、删除部分子节点，当 DOM 节点发生变化时，就会产生 DOM 变化记录的微任务。</li><li>使用 Promise</li></ul><h3 id="Promise"><a href="#Promise" class="headerlink" title="Promise"></a>Promise</h3><p>页面编程中常见的方式是异步编程，但是这样的编程方式有以下几个缺点：</p><ul><li>逻辑不连续，反人类直觉</li><li>处理复杂业务逻辑时，充斥着嵌套多层的回调函数</li><li>需要处理每一个回调函数的失败情况</li></ul><p>Promise 为了解决这些问题，用了以下几个技术：</p><ul><li>回调函数延迟绑定以及回调函数的返回值穿透</li><li>任务失败的对象具有冒泡性质</li><li>Promise 的任务结果处理函数，是利用微任务来执行的。</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;blockquote&gt;
&lt;p&gt;本系列为极客时间上的&lt;a href=&quot;https://time.geekbang.org/column/intro/216&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;《浏览器工作原理与实践》&lt;/a&gt;专栏的学习笔记&lt;/p&gt;
&lt;/blockquote&gt;
&lt;h2 id=&quot;消息队列和事件循环&quot;&gt;&lt;a href=&quot;#消息队列和事件循环&quot; class=&quot;headerlink&quot; title=&quot;消息队列和事件循环&quot;&gt;&lt;/a&gt;消息队列和事件循环&lt;/h2&gt;&lt;p&gt;每个渲染进程都会有一个主线程，用来处理各种任务：解析 DOM、执行 JavaScript、响应用户的交互事件、执行动画等。如果要有序的处理这些任务，就必须有一个专门的调度系统来协调，在浏览器中，这个调度系统就是消息队列和事件循环。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>浏览器工作原理学习笔记(二)-V8工作原理</title>
    <link href="http://silencewh.xin/2020/01/01/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E4%BA%8C-V8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86/"/>
    <id>http://silencewh.xin/2020/01/01/浏览器工作原理学习笔记-二-V8工作原理/</id>
    <published>2019-12-31T16:08:48.000Z</published>
    <updated>2019-12-31T08:09:05.260Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>本系列为极客时间上的<a href="https://time.geekbang.org/column/intro/216" target="_blank" rel="noopener">《浏览器工作原理与实践》</a>专栏的学习笔记</p></blockquote><h2 id="数据存储"><a href="#数据存储" class="headerlink" title="数据存储"></a>数据存储</h2><p>JavaScript 的数据类型分为两大类：原始类型和引用类型，他们在内存中的存储位置是不一样的。内存空间分为三类：代码空间、栈空间和堆空间。代码空间，顾名思义就是存储执行代码的地方。剩下的栈空间和堆空间就是用来存储我们程序中的数据的，比如我们定义的各种类型的变量以及生产出来的数据。</p><a id="more"></a><p>栈空间也就是调用栈，是用来存储执行上下文的。当 JavaScript 程序执行的时候，会先创建一个全局执行上下文，接着执行函数的时候，也会创建该函数的执行上下文，里面包含变量环境和词法环境。变量环境里存储的是变量名和变量值。如果某个变量是原始类型，那么变量值就会存储在栈中。但是如果某个变量是引用类型的话，那么栈中存储的变量值只一个<strong>引用地址</strong>，真正的值是存放在<strong>堆空间</strong>。所以对于一些引用类型的变量的赋值，其实赋值的是引用地址。</p><p>这样做的原因是因为，JavaScript 引擎需要用栈来维护程序执行期间的上下文状态，如果所有的数据都存放在栈中的话，会影响到上下文切换的效率。</p><p>在一个函数执行完之后，对应的执行上下文会被销毁（通过移动指针）。但是如果创建了一个闭包的话，里面引用的变量会被保留下来，这是为什么呢？</p><p>因为在编译过程中，对于一些内部函数，JavaScript 引擎会做一个快速的扫描，如果发现内部函数有引用到外部变量的话，就会<strong>在堆空间中</strong>创建一个 closure(foo) 对象，用来保存引用到的外部变量。这样在函数执行完之后，返回的内部函数也引用到了 closure(foo) 对象，这样在下次执行这些内部函数时，创建的执行上下文中就包含了 closure(foo) 对象。</p><h2 id="垃圾回收"><a href="#垃圾回收" class="headerlink" title="垃圾回收"></a>垃圾回收</h2><h3 id="调用栈中的数据回收"><a href="#调用栈中的数据回收" class="headerlink" title="调用栈中的数据回收"></a>调用栈中的数据回收</h3><p>当执行到函数 A 的时候，该函数的执行上下文会被压入到调用栈中，同时，还有一个记录当前执行状态的指针（称为 ESP），指向调用栈中函数 A 的执行上下文。</p><p>当函数 A 执行完毕之后，ESP 会进行下移，这个下移操作就是销毁函数 A 的执行上下文的过程。因为等到执行其他函数 B 的时候，会入栈直接覆盖掉之前函数 A 的内存。</p><h3 id="堆中的数据回收"><a href="#堆中的数据回收" class="headerlink" title="堆中的数据回收"></a>堆中的数据回收</h3><blockquote><p>代际假说：<br>大部分对象在内存中存在的时间很短，简单来说，就是很多对象一经分配内存，很快就变得不可访问；<br>不死的对象，会活得更久；</p></blockquote><p>V8 会把堆分为<strong>新生代</strong>和<strong>老生代</strong>两个区域，新生代中存放的是生存时间短的对象，同时分配的空间也比较小。老生代中存放的是生存时间长的对象，同时分配的空间也比较大。</p><p>V8 采用两个垃圾回收器用来分别回收这两个区域的垃圾数据：<br>副垃圾回收器，主要负责新生代的垃圾回收。<br>主垃圾回收器，主要负责老生代的垃圾回收。</p><p>垃圾回收器的主要工作流程如下：</p><ol><li>标记空间中活动对象和非活动对象</li><li>回收非活动对象的内存空间</li><li>内存整理。经过多次回收之后会产生大量不连续的内存碎片，如果不及时整理，就无法为接下来需要占用大内存空间的对象分配内存。</li></ol><h4 id="副垃圾回收器处理流程"><a href="#副垃圾回收器处理流程" class="headerlink" title="副垃圾回收器处理流程"></a>副垃圾回收器处理流程</h4><p>新生代对半划分为两个区域：对象区和空闲区。</p><p>新加入的对象会被放到对象区域，对象区域快要被写满的时候，就会执行一次垃圾清理。</p><p>首先对对象区域进行标记，然后将存活的对象复制到空闲区域，复制的过程中会有序排列起来，这样最后复制完成之后，就不会有内存碎片的存在。</p><p>复制完成之后，将对象区域和空闲区域进行角色翻转，也就是原来的对象区域变成空闲区域，原来的空闲区域变成了对象区域。这样就完成了垃圾对象的回收操作，同时这种角色翻转的操作还能让新生代中的这两块区域无限重复使用下去。</p><p>为了执行效率，一般新生区的空间会被设置得比较小。经过两次垃圾回收依然还存活的对象，会通过对象晋升策略，被移动到老生代中。</p><h4 id="主垃圾回收器处理流程"><a href="#主垃圾回收器处理流程" class="headerlink" title="主垃圾回收器处理流程"></a>主垃圾回收器处理流程</h4><p>主垃圾回收器是采用标记 - 清除（Mark-Sweep）的算法进行垃圾回收的。递归遍历根元素，把能到达的元素归为活动元素，未到达的元素归为垃圾数据。标记完成之后，就会进行垃圾清除。</p><p>多次清除之后，会产生大量不连续的碎片，就需要进行整理，于是又产生了另外一种算法——标记 - 整理（Mark-Compact）。这个标记过程仍然与标记 - 清除算法里的是一样的，但后续步骤不是直接对可回收对象进行清理，而是让所有存活的对象都向一端移动，然后直接清理掉端边界以外的内存。</p><p><img src="http://i1.fuimg.com/706472/b5bdc1d877b179e0.png" alt="Markdown"></p><h3 id="全停顿"><a href="#全停顿" class="headerlink" title="全停顿"></a>全停顿</h3><p>由于 JavaScript 是运行在主线程之上的，一旦执行垃圾回收算法，都需要将正在执行的 JavaScript 脚本暂停下来，待垃圾回收完毕后再恢复脚本执行。我们把这种行为叫做全停顿（Stop-The-World）。</p><p>为了减小全停顿带来的影响，V8 将标记过程分为一个个的子标记过程，同时将标记过程与 JavaScript 应用逻辑交替进行，直到标记阶段结束。我们把这个算法称为增量标记（Incremental Marking）算法。</p><p><img src="http://i1.fuimg.com/706472/142bc9c1ef14291b.png" alt="Markdown"></p><h2 id="V8-如何执行一段-JavaScript-代码"><a href="#V8-如何执行一段-JavaScript-代码" class="headerlink" title="V8 如何执行一段 JavaScript 代码"></a>V8 如何执行一段 JavaScript 代码</h2><p>相关名词：编译器（Compiler）、解释器（Interpreter）、抽象语法树（AST）、字节码（Bytecode）、即时编译器（JIT）。</p><p>编译器和解释器存在的目的就是将我们编写的代码，”翻译“成机器能够理解的语言。大致过程如下：</p><p><img src="http://i1.fuimg.com/706472/1e435b9be73f4a51.png" alt="Markdown"></p><p>编译型语言在执行之前，就会被编译成机器能够读懂的二进制文件。每次运行的时候，可以直接运行编译过后的文件。</p><p>解释型语言在每次执行的时候，都会由解释器对程序进行动态的解释和执行。</p><p>抽象语法树（AST），为了能够让机器更好的处理由高级程序语言编写的代码，首先需要将代码转化为 AST，它是代码的一种<strong>结构化表示</strong>，是后续处理流程的前提。</p><p>AST 的生成过程由两阶段组成：分词（词法分析）和解析（语法分析）。分词是将源码拆解成一个个 token （指的是语法上不可再分的最小的单个字符或字符串）。语法分析是将 token 按照语法规则转为 AST，只要源码符合语法规则，这一步就会顺利完成。</p><p><img src="http://i1.fuimg.com/706472/6da305b0a5dfb340.png" alt="Markdown"></p><p>上图是 V8 引擎执行一段代码的流程图，有了 AST 之后，解释器就会将 AST 转换为字节码，并且逐行解释执行。</p><blockquote><p>字节码就是介于 AST 和机器码之间的一种代码。但是与特定类型的机器码无关，字节码需要通过解释器将其转换为机器码后才能执行。</p></blockquote><p>为什么要在机器码之前引入字节码？因为机器码需要占据大量的存储空间，在一些低内存的移动设备上，内存占用问题就会显露出来。使用字节码，可以减少系统的内存使用。</p><p>第一次执行的字节码，解释器会逐条解释执行。在执行的过程中，如果有发现热点代码（HotSpot），比如一段代码被重复执行多次，那么后台的编译器 TurboFan 就会把该段热点的字节码编译为高效的机器码，然后当再次执行这段被优化的代码时，只需要执行编译后的机器码就可以了，这样就大大提升了代码的执行效率。</p><p>这种字节码配合解释器和编译器的技术，就是即时编译（JIT）。具体到 V8，就是指解释器 Ignition 在解释执行字节码的同时，收集代码信息，当它发现某一部分代码变热了之后，TurboFan 编译器便闪亮登场，把热点的字节码转换为机器码，并把转换后的机器码保存起来，以备下次使用。</p>]]></content>
    
    <summary type="html">
    
      &lt;blockquote&gt;
&lt;p&gt;本系列为极客时间上的&lt;a href=&quot;https://time.geekbang.org/column/intro/216&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;《浏览器工作原理与实践》&lt;/a&gt;专栏的学习笔记&lt;/p&gt;
&lt;/blockquote&gt;
&lt;h2 id=&quot;数据存储&quot;&gt;&lt;a href=&quot;#数据存储&quot; class=&quot;headerlink&quot; title=&quot;数据存储&quot;&gt;&lt;/a&gt;数据存储&lt;/h2&gt;&lt;p&gt;JavaScript 的数据类型分为两大类：原始类型和引用类型，他们在内存中的存储位置是不一样的。内存空间分为三类：代码空间、栈空间和堆空间。代码空间，顾名思义就是存储执行代码的地方。剩下的栈空间和堆空间就是用来存储我们程序中的数据的，比如我们定义的各种类型的变量以及生产出来的数据。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>浏览器工作原理学习笔记(一)-浏览器概览</title>
    <link href="http://silencewh.xin/2019/12/23/%E6%B5%8F%E8%A7%88%E5%99%A8%E5%B7%A5%E4%BD%9C%E5%8E%9F%E7%90%86%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0-%E4%B8%80-%E6%B5%8F%E8%A7%88%E5%99%A8%E6%A6%82%E8%A7%88/"/>
    <id>http://silencewh.xin/2019/12/23/浏览器工作原理学习笔记-一-浏览器概览/</id>
    <published>2019-12-23T11:31:30.000Z</published>
    <updated>2019-12-23T03:34:22.820Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>本系列为极客时间上的<a href="https://time.geekbang.org/column/intro/216" target="_blank" rel="noopener">《浏览器工作原理与实践》</a>专栏的学习笔记</p></blockquote><h2 id="浏览器架构变迁"><a href="#浏览器架构变迁" class="headerlink" title="浏览器架构变迁"></a>浏览器架构变迁</h2><p>起初浏览器为单进程架构，页面、插件、网络等其他模块都在一个进程下面工作（多个线程），只要有一个线程出现问题，就会导致整个浏览器崩溃。这种架构不稳定、不安全、不流畅。如下图所示：</p><a id="more"></a><p><img src="http://i2.tiimg.com/706472/df649e67d5a3094d.png" alt="Markdown"></p><p>后面架构升级为多进程架构，分为渲染进程、插件进程、网络进程、GPU 进程和浏览器主进程。每个页面和插件都有自己单独的进程，保证了独立性，互不影响，单个页面或者插件出问题之后，不会影响到整个浏览器，将其关闭就好。而且渲染进程被隔离在沙箱内，保证了系统的安全性。如下图所示：</p><p><img src="http://i2.tiimg.com/706472/3deb725de2d333fa.png" alt="Markdown"></p><p>未来浏览器的架构方向是面向服务的架构，也就是将浏览器的底层能力划分为一个个基础服务，每个服务在独立的进程内运行，互相通过 IPC 通信。构建一个更内聚、低耦合、易于扩展和维护的系统。如下图所示：</p><p><img src="http://i2.tiimg.com/706472/19383820160b6f33.png" alt="Markdown"></p><h2 id="浏览器数据包传输"><a href="#浏览器数据包传输" class="headerlink" title="浏览器数据包传输"></a>浏览器数据包传输</h2><p>互联网的数据是通过数据包来传输的。如果发送的的数据过大，会拆分成一个个小的数据包进行传输，浏览器的网络传输是基于 TCP/IP 协议簇进行。</p><p>IP 协议位于网络层，主要的职责是将数据从一个主机地址传输到另一个主机地址，这里的主机地址就是指的 IP。传输方式是在基础数据包的基础上加上 IP 头信息，里面包含了源 IP 地址、目标 IP 地址等信息。</p><p>UDP （用户数据包协议），负责将应用程序通过端口号与网络数据包连接起来。IP 接收到数据包之后，UDP 通过端口号将数据包分发给对应的应用程序。UDP 的特点是：传输速度快，但是不保证传输可靠性（会丢包）。</p><p>TCP 协议是一个可靠、稳定、面向连接的传输层协议，它解决了 UDP 的缺点，特点如下：</p><ul><li><p>提供重传机制，解决丢包的问题</p></li><li><p>大的数据包会拆分成若干个小数据包，接收端收到之后再按照序号拼接</p></li></ul><p>一个完整的 TCP 生命周期包括：建立连接（三次握手）、数据传输、断开连接（四次挥手）</p><h3 id="一个完整的-HTTP-请求过程"><a href="#一个完整的-HTTP-请求过程" class="headerlink" title="一个完整的 HTTP 请求过程"></a>一个完整的 HTTP 请求过程</h3><ol><li>构建请求<ul><li>构建请求行信息</li></ul></li><li>查找缓存<ul><li>页面数据本地缓存</li><li>缓存对应头字段：Cache-Control，不同的值带来不同的缓存生命周期</li></ul></li><li>准备 IP 地址和端口<ul><li>IP 地址通过 DNS 查询获取，并且会优先查找本地的 DNS 缓存</li></ul></li><li>等待 TCP 队列<ul><li>Chrome 对于每个域名只能分配 6 个 TCP 连接</li></ul></li><li>建立 TCP 连接</li><li>发送 HTTP 请求<ul><li>请求行、请求头、请求体</li><li>如有对应的 Cookie ，会携带，用于持久化登录态</li></ul></li><li>等到服务端 HTTP 响应<ul><li>响应行、响应头、响应体</li></ul></li><li>断开连接/重定向<ul><li>如果 HTTP 状态码为 301 或 302 ，浏览器需要重定向到另一个地址访问</li></ul></li></ol><h2 id="从输入-URL-到页面展示完整"><a href="#从输入-URL-到页面展示完整" class="headerlink" title="从输入 URL 到页面展示完整"></a>从输入 URL 到页面展示完整</h2><h3 id="导航阶段"><a href="#导航阶段" class="headerlink" title="导航阶段"></a>导航阶段</h3><p>流程示意图：</p><p><img src="http://i2.tiimg.com/706472/a72269e27885564d.png" alt="Markdown"></p><ol><li><p>用户输入请求信息</p></li><li><p>网络进程发起 URL 请求</p></li><li><p>服务器响应之后，浏览器进程开始准备渲染进程</p></li></ol><ul><li>如果 HTTP 响应码是 301 或者是 302 ，浏览器会有一个重定向的过程</li><li>响应头中的 Content-Type 决定浏览器如何处理响应内容，影响着后续流程，如果是 HTML 页面，那么 Content-Type 的值应该是 text/html</li><li>每打开一个页面，浏览器都会准备一个新的进程，有一种情况例外，就是新打开的页面和之前的页面属于<strong>同一站点</strong>时，这时候会复用前一个进程</li></ul><ol><li><p>渲染进程准备好之后，就会通知浏览器进程已经做好展示页面状态的准备，这个过程称为“<strong>提交文档</strong>”</p></li><li><p>浏览器进程接收到提交文档的消息后，便会移除旧的文档，同时通知渲染进程文档已提交，渲染进程进入<strong>解析页面</strong>阶段</p><p><strong>这个过程就叫做 “导航”</strong></p></li></ol><h3 id="渲染流程"><a href="#渲染流程" class="headerlink" title="渲染流程"></a>渲染流程</h3><p><img src="http://i2.tiimg.com/706472/d2877702697009e6.png" alt="Markdown"></p><p>按照渲染的时间顺序，渲染流水线可以分为如下几个子阶段：</p><p>构建 DOM 树 =&gt; 样式计算 =&gt; 布局阶段 =&gt; 分层 =&gt; 绘制 =&gt; 分块 =&gt; 光栅化 =&gt; 合成</p><p>每个子阶段都可以看成是一个函数，接收输入参数，进行本阶段的处理，然后输出相应的处理结果给下一个子阶段。多个子阶段构成一条渲染流水线。</p><h4 id="1-构建-DOM-树"><a href="#1-构建-DOM-树" class="headerlink" title="1. 构建 DOM 树"></a>1. 构建 DOM 树</h4><p>将简单的 HTML 代码，经由解析器解析，最终转换为一个树状结构，包含节点和内容，方便接下来流程的处理。</p><h4 id="2-样式计算"><a href="#2-样式计算" class="headerlink" title="2. 样式计算"></a>2. 样式计算</h4><ul><li><p>为了将 CSS 文件转换成浏览器能够理解的结构，先要进行一步<strong>转换</strong>的操作，解析 CSS 文件，输出 styleSheets</p></li><li><p>接下来是将<strong>CSS 的属性值标准化</strong></p></li><li>然后根据 CSS 继承和层叠的规则，计算每个 DOM 节点的样式</li></ul><h4 id="3-布局阶段"><a href="#3-布局阶段" class="headerlink" title="3. 布局阶段"></a>3. 布局阶段</h4><p>计算 DOM 树中<strong>可见节点</strong>的几何位置的过程，就叫做布局。</p><ul><li>创建布局树，构建一棵只包含可见元素的布局树</li><li>布局计算，计算 DOM 树节点的坐标位置</li></ul><h4 id="4-分层"><a href="#4-分层" class="headerlink" title="4. 分层"></a>4. 分层</h4><p>为了完成页面很多复杂的效果，渲染引擎会为一些特定的节点生成对应的图层，最终形成一棵图层树。满足以下两点中的任意一点都会形成一个对应的图层：</p><ul><li>拥有层叠上下文属性（定位属性、透明度定义、CSS 滤镜）</li><li>需要裁剪的地方（内容溢出容器，就会发生裁剪）</li></ul><h4 id="5-图层绘制"><a href="#5-图层绘制" class="headerlink" title="5. 图层绘制"></a>5. 图层绘制</h4><p>图层的绘制会被分解成一个个绘制指令，形成绘制列表</p><h4 id="6-栅格化（raster）操作"><a href="#6-栅格化（raster）操作" class="headerlink" title="6. 栅格化（raster）操作"></a>6. 栅格化（raster）操作</h4><p>当图层的绘制列表准备好之后，渲染线程的主线程会将绘制列表提交（commit）给合成线程。</p><p>合成线程将图层划分为图块，视口附近的图块会被优先转化为位图，生成位图的操作是由栅格化来进行的。栅格化，就是将图块转换为位图。</p><p>渲染引擎维护了一个栅格化的线程池，所有的图块栅格化都是在线程池中进行的。</p><p>一般栅格化线程都会由 GPU 来加速进行，生成的位图会保存在 GPU 的内存中。</p><p><img src="http://i2.tiimg.com/706472/b1c45068aee33d99.png" alt="Markdown"></p><h4 id="7-合成和显示"><a href="#7-合成和显示" class="headerlink" title="7. 合成和显示"></a>7. 合成和显示</h4><p>所有的图块光栅化之后，合成线程会发出一个绘制图块的命令-“DrawQuad”，提交给浏览器进程。</p><p>浏览器进程里有一个叫 viz 的组件，用来接收 DrawQuad 命令，根据这个命令，将页面内容绘制到内存中，最后再显示在屏幕上。</p><p>至此，用户就可以看见最终的页面了。</p>]]></content>
    
    <summary type="html">
    
      &lt;blockquote&gt;
&lt;p&gt;本系列为极客时间上的&lt;a href=&quot;https://time.geekbang.org/column/intro/216&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;《浏览器工作原理与实践》&lt;/a&gt;专栏的学习笔记&lt;/p&gt;
&lt;/blockquote&gt;
&lt;h2 id=&quot;浏览器架构变迁&quot;&gt;&lt;a href=&quot;#浏览器架构变迁&quot; class=&quot;headerlink&quot; title=&quot;浏览器架构变迁&quot;&gt;&lt;/a&gt;浏览器架构变迁&lt;/h2&gt;&lt;p&gt;起初浏览器为单进程架构，页面、插件、网络等其他模块都在一个进程下面工作（多个线程），只要有一个线程出现问题，就会导致整个浏览器崩溃。这种架构不稳定、不安全、不流畅。如下图所示：&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="http://silencewh.xin/tags/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
  </entry>
  
  <entry>
    <title>拾起笔</title>
    <link href="http://silencewh.xin/2018/07/09/%E6%8B%BE%E8%B5%B7%E7%AC%94/"/>
    <id>http://silencewh.xin/2018/07/09/拾起笔/</id>
    <published>2018-07-08T23:17:15.000Z</published>
    <updated>2019-11-27T10:25:29.942Z</updated>
    
    <content type="html"><![CDATA[<p>说来惭愧，博客搭建起来之后，一直都没有认真的好好总结自己的技术学习，没有沉淀，博客上只有寥寥三篇文章。那三篇文章都好像是在嘲笑我的懒惰。</p><p>今天将自己 2018 年剩下的时间里好好总结了一下，希望自己不要再浑浑噩噩，按照自己的计划认真执行。</p><a id="more"></a><h2 id="英语学习计划"><a href="#英语学习计划" class="headerlink" title="英语学习计划"></a>英语学习计划</h2><p>目前在看一本书叫《程序员的英语》。主要形式是英语科技类文章的阅读、翻译和部分生词的解释。类似于读书时期的阅读理解，对于自己整体阅读的能力会有提高的作用。而我目前最需要的也是整体阅读能力，以及单词量的积累。</p><p>整本书一共 33 篇文章，目前已经阅读完两篇，剩下 31 篇。目前的计划是每天一篇文章，一个月将这本书阅读完。这样也算是前期给自己英语学习的一个“预热”。</p><p>接下来的计划是，在“众成翻译”网站上接一些难度较小，<em>自己感兴趣</em>的文章进行翻译，一定是要自己感兴趣的，否则很难坚持下去。前期计划是一周一篇。</p><p>其次每天日常的英语学习内容应该是阅读 Medium 上的一些文章，以自己感兴趣的为主。不求每个单词都能认识，但是要在阅读文章的过程中，培养自己的语感以及单词量的积累。</p><p>下载了扇贝单词 APP，每天花个十几分钟左右的时间，或者是利用自己的一些碎屏时间，来记忆一些单词。为什么没有专门花时间来背单词？因为目前来说，一是可能没有那么多时间，二是单纯的背单词效果不是很好，而且很容易“学习疲劳”，因此目前还是以在阅读过程中积累单词为主。</p><h2 id="Python-入门学习计划"><a href="#Python-入门学习计划" class="headerlink" title="Python 入门学习计划"></a>Python 入门学习计划</h2><p>目前有《Python 编程从入门到实践》这本书，看书名就知道很靠谱，因为它不是叫“从入门到精通”。而且很多人都推荐这本书。我觉得我的 Python 入门学习的目标很明确，也很贴切对 Python 的第一印象，就是学会用 Python 写爬虫。</p><p>都说 Python 的语法很简单，上手容易，那么就需要多敲代码，避免眼高手低。因为理论学习只是第一步，可以将自己的想法写出来才是最重要的。</p><p>前期的计划是每两天花大概一个到两个小时的时间来学习 Python，主要是看书和敲代码，平常需要关注一下 Python 的相关公众号，了解目前 Python 的应用场景都有哪些。</p><p>这本书读完之后，我想自己就可以用 Python 实现一些小程序了，但是关于整个工程的搭建和部署，以及一些框架的选择，都需要在 Github 上或者是社区里进行学习。</p><h2 id="前端学习计划"><a href="#前端学习计划" class="headerlink" title="前端学习计划"></a>前端学习计划</h2><p>前端技术是自己吃饭的本钱，也是带领自己走向编程这一领域的启蒙老师。近两年，前端开发还会是我的主要工作，我现在已经走过了最初的前端学习阶段，各个前端方面的知识也是略有涉及，但是接下来需要做的就是<em>弥补自己的短板和进阶自己的长处</em>。</p><p>反观自己在前端领域的学习过程，以及前段时间面试所暴露出来的问题，自己的学习方式还是有待改进的，至少需要提高自己的学习效率。</p><p>目前自己的短板是在 CSS、移动端和 Node 方面。为什么把 Node 也加入到短板行列？因为一个合格的前端必须要熟 Node。CSS 以及移动端的短板和自己的兴趣点以及工作内容有关系。我自己本身对于 CSS 的热情不是很高，满足于实现基本的样式即可，没有深入探究或者是针对性的学习过。而移动端的短板主要是工作内容的侧重点还是偏向于 PC 端，而且即使有移动端的项目，要求也不是很高。这几点原因所导致的。</p><p>关于 CSS 和移动端的学习，我目前觉得《指尖上行》这本书比较适合我。这本书虽然是属于移动端开发的进阶读物，但是书中涉及到大量的复杂的样式、动画以及移动端的优化。所以我觉得这是我所需要的书籍。如果单纯的让我阅读 CSS 书籍，学习效率可能会很低。</p><p>自己本身更偏向于 JS 的学习和研究，也是自己的兴趣所在。关于 JS 的进阶学习，目前在看《你不知道的 JavaScript（上卷）》。这本书是非常优秀的进阶书籍，书中讨论了很多 JS 中较复杂难懂，但是是必须要掌握的核心要点。</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>希望计划”不止于计划“，自己要认真的去执行。更需要的是学习过程中要有沉淀和总结，希望自己慢慢地将这个博客充实起来。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;说来惭愧，博客搭建起来之后，一直都没有认真的好好总结自己的技术学习，没有沉淀，博客上只有寥寥三篇文章。那三篇文章都好像是在嘲笑我的懒惰。&lt;/p&gt;
&lt;p&gt;今天将自己 2018 年剩下的时间里好好总结了一下，希望自己不要再浑浑噩噩，按照自己的计划认真执行。&lt;/p&gt;
    
    </summary>
    
    
      <category term="随笔" scheme="http://silencewh.xin/tags/%E9%9A%8F%E7%AC%94/"/>
    
  </entry>
  
  <entry>
    <title>Node.js 项目服务端部署</title>
    <link href="http://silencewh.xin/2017/07/20/Node.js%20%E9%A1%B9%E7%9B%AE%E6%9C%8D%E5%8A%A1%E7%AB%AF%E9%83%A8%E7%BD%B2/"/>
    <id>http://silencewh.xin/2017/07/20/Node.js 项目服务端部署/</id>
    <published>2017-07-19T17:37:35.000Z</published>
    <updated>2019-11-27T10:24:24.205Z</updated>
    
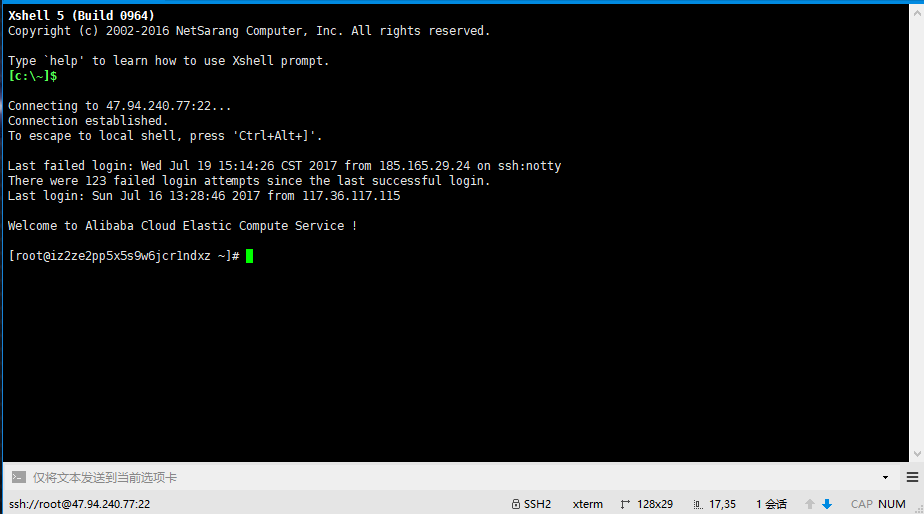
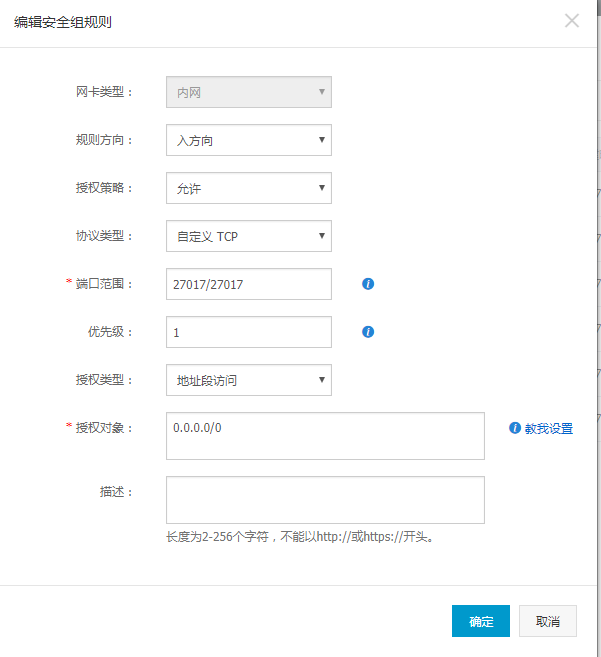
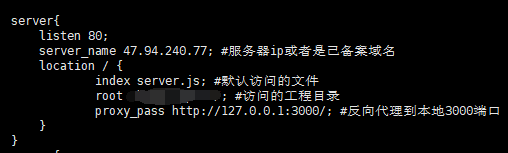
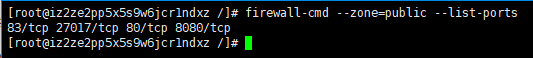
    <content type="html"><![CDATA[<h2 id="1-部署环境"><a href="#1-部署环境" class="headerlink" title="1. 部署环境"></a>1. 部署环境</h2><p>我是在阿里云上买的专有网络的云服务器，配置是：CPU 1 核，内存 1GB，操作系统 CentOS 7.3 64 位，带宽 1Mbps。配置很低，因为便宜嘛，平时自己的一些小 demo 够了。以下的部署步骤基于此环境。</p><p>之前部署过几次，都是在网络上东找找西找找的配置文章，本身对于服务器相关的知识一窍不通，因此配置完了也就忘了。最近刚在这台新服务器上部署了 Node 的运行环境，借此记录下步骤，以便日后查找，也给有需要的朋友一些参考价值。</p><a id="more"></a><h2 id="2-开始部署"><a href="#2-开始部署" class="headerlink" title="2. 开始部署"></a>2. 开始部署</h2><h3 id="工具"><a href="#工具" class="headerlink" title="工具"></a>工具</h3><p>我是在 Windows 下进行部署的，用的工具是 Xshell 5，下载地址在这：<a href="https://www.netsarang.com/download/down_xsh5.html" target="_blank" rel="noopener">https://www.netsarang.com/download/down_xsh5.html</a></p><h3 id="开始部署"><a href="#开始部署" class="headerlink" title="开始部署"></a>开始部署</h3><p>在 Xshell 5 上输入服务器的 IP、密码和用户，登录成功后如下图所示：</p><p><img src="https://silencewanghui.github.io/images/部署01.png" alt="部署01"></p><p>首先将 yum 更新至最新版本：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">yum -y update</span><br></pre></td></tr></table></figure><p>安装编译源代码需要的一些开发工具：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">yum -y groupinstall &quot;Development Tools&quot;</span><br></pre></td></tr></table></figure><h4 id="Node-js-安装"><a href="#Node-js-安装" class="headerlink" title="Node.js 安装"></a>Node.js 安装</h4><ol><li><p>先进入 /usr/src 文件夹</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">cd /usr/src</span><br></pre></td></tr></table></figure></li><li><p>从<a href="https://nodejs.org/en/download/" target="_blank" rel="noopener">官网</a>获取稳定版本，我选择的版本是 6.11.1</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">wget https://nodejs.org/dist/v6.11.1/node-v6.11.1.tar.gz</span><br></pre></td></tr></table></figure></li><li><p>下载完成之后，解压文件，并进入解压过后的文件夹</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">tar zxf node-v6.11.1.tar.gz</span><br><span class="line">cd node-v6.11.1</span><br></pre></td></tr></table></figure></li><li><p>执行配置脚本来进行编译预处理</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">./configure</span><br></pre></td></tr></table></figure></li><li><p>编译源代码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">make</span><br></pre></td></tr></table></figure></li><li><p>编译完成之后，开始安装</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">make install</span><br></pre></td></tr></table></figure></li><li><p>没有意外的话 Node 已经安装好了，可以敲出 node -v 来查看安装的版本号</p></li></ol><p>=============================我是分割线===================================</p><h4 id="使用-nvm-安装-Node（推荐）"><a href="#使用-nvm-安装-Node（推荐）" class="headerlink" title="使用 nvm 安装 Node（推荐）"></a>使用 nvm 安装 Node（推荐）</h4><ol><li><p>安装 nvm</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">wget -qO- https://raw.githubusercontent.com/creationix/nvm/v0.33.2/install.sh | bash</span><br></pre></td></tr></table></figure></li><li><p>执行以下命令以使用 nvm</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">export NVM_DIR=&quot;$HOME/.nvm&quot;</span><br><span class="line">[ -s &quot;$NVM_DIR/nvm.sh&quot; ] &amp;&amp; . &quot;$NVM_DIR/nvm.sh&quot; # This loads nvm</span><br></pre></td></tr></table></figure></li><li><p>安装 Node 最新的发布版本</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">nvm install node</span><br></pre></td></tr></table></figure></li><li><p>使用 Node</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">nvm use node</span><br><span class="line">或者</span><br><span class="line">nvm run node --version (运行指定版本的 Node)</span><br></pre></td></tr></table></figure><p>具体使用请参照 nvm 的<a href="https://github.com/creationix/nvm" target="_blank" rel="noopener">官方文档</a></p></li></ol><p>Node 安装成功之后，可以再安装 <a href="http://pm2.keymetrics.io/" target="_blank" rel="noopener">pm2</a> ，用来启动和监控 Node 程序，并且可以在 Node 程序文件被替换和程序报错时，自动进行重启。</p><h4 id="MongoDB-安装"><a href="#MongoDB-安装" class="headerlink" title="MongoDB 安装"></a>MongoDB 安装</h4><ol><li><p>进入 /usr/local ，下载 <a href="https://www.mongodb.com/download-center?jmp=tutorials&amp;_ga=2.78479636.1260591818.1500450443-970533465.1498728612#community" target="_blank" rel="noopener">MongoDB</a> 源码</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">cd /usr/local</span><br><span class="line">wget https://fastdl.mongodb.org/linux/mongodb-linux-x86_64-3.4.6.tgz</span><br></pre></td></tr></table></figure></li><li><p>解压安装包，重命名文件夹为 mongodb3</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">tar zxvf mongodb-linux-x86_64-3.4.6.tgz</span><br><span class="line">mv mongodb-linux-x86_64-3.4.6 mongodb3</span><br></pre></td></tr></table></figure></li><li><p>在 /usr/local 文件夹内建立 mongodata 文件夹，用于存放数据和日志以及配置文件（该位置可以自定义）</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">mkdir /usr/local/mongodata</span><br><span class="line">mkdir /usr/local/mongodata/db</span><br><span class="line">mkdir /usr/local/mongodata/logs</span><br></pre></td></tr></table></figure></li><li><p>编辑配置文件</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">vi /usr/local/mongodata/mongo.conf</span><br></pre></td></tr></table></figure></li><li><p>将配置文件改为如下</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">#端口号</span><br><span class="line">port=27017</span><br><span class="line">#访问IP（这里设置成不限定）</span><br><span class="line">bind_ip=0.0.0.0</span><br><span class="line">#数据目录</span><br><span class="line">dbpath=/usr/local/mongodata/db</span><br><span class="line">#日志目录</span><br><span class="line">logpath=/usr/local/mongodata/logs</span><br><span class="line">#设置后台运行</span><br><span class="line">fork=true</span><br><span class="line">#日志输出方式</span><br><span class="line">logappend=true</span><br><span class="line">shardsvr=truedirectoryperdb=true</span><br><span class="line">#开启认证（暂时不开启）</span><br><span class="line">#auth=true</span><br></pre></td></tr></table></figure></li><li><p>进入到安装目录，启动运行</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">./bin/mongod --config /usr/local/mongodata/mongo.conf</span><br></pre></td></tr></table></figure></li><li><p>打开数据库</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">./bin/mongo</span><br></pre></td></tr></table></figure></li><li><p>需要关闭数据库时，要执行以下语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">db.shutdownServer()</span><br></pre></td></tr></table></figure></li><li><p>配置账号密码，下面的 admin 用户的权限是 userAdminAnyDatabase</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br></pre></td><td class="code"><pre><span class="line">&gt; show dbs</span><br><span class="line">local  0.078GB</span><br><span class="line">test   0.078GB</span><br><span class="line">&gt; use admin</span><br><span class="line">switched to db admin</span><br><span class="line">&gt; db.createUser(</span><br><span class="line">...   &#123;</span><br><span class="line">...     user: &quot;admin&quot;,</span><br><span class="line">... pwd: &quot;admin&quot;,</span><br><span class="line">...     roles: [ &#123; role: &quot;userAdminAnyDatabase&quot;, db: &quot;admin&quot; &#125; ]</span><br><span class="line">...   &#125;</span><br><span class="line">... )</span><br><span class="line">Successfully added user: &#123;</span><br><span class="line">    &quot;user&quot; : &quot;admin&quot;,</span><br><span class="line">    &quot;roles&quot; : [</span><br><span class="line">        &#123;</span><br><span class="line">            &quot;role&quot; : &quot;userAdminAnyDatabase&quot;,</span><br><span class="line">            &quot;db&quot; : &quot;admin&quot;</span><br><span class="line">        &#125;</span><br><span class="line">    ]</span><br><span class="line">&#125;</span><br><span class="line">&gt; show users</span><br><span class="line">&#123;</span><br><span class="line">    &quot;_id&quot; : &quot;admin.admin&quot;,</span><br><span class="line">    &quot;user&quot; : &quot;admin&quot;,</span><br><span class="line">    &quot;db&quot; : &quot;admin&quot;,</span><br><span class="line">    &quot;roles&quot; : [</span><br><span class="line">        &#123;</span><br><span class="line">            &quot;role&quot; : &quot;userAdminAnyDatabase&quot;,</span><br><span class="line">            &quot;db&quot; : &quot;admin&quot;</span><br><span class="line">        &#125;</span><br><span class="line">    ]</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></li><li><p>配置完账号密码后，现在可以将配置文件中的认证放开了</p></li></ol><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">#开启认证</span><br><span class="line">auth=true</span><br></pre></td></tr></table></figure><ol><li><p>重启数据库，并增加账号 test1 对于 test 数据库，test1 的权限是 readWrite</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line">./bin/mongo</span><br><span class="line">MongoDB shell version: 3.4.5</span><br><span class="line">connecting to: test</span><br><span class="line">&gt; use admin</span><br><span class="line">switched to db admin</span><br><span class="line">&gt; db.auth(&quot;admin&quot;,&quot;admin&quot;)</span><br><span class="line">1</span><br><span class="line">&gt; use test</span><br><span class="line">switched to db test</span><br><span class="line">db.createUser(</span><br><span class="line">... ...  &#123;</span><br><span class="line">... ...    user: &quot;test1&quot;,</span><br><span class="line">... ... pwd: &quot;test1&quot;,</span><br><span class="line">... ...    roles: [</span><br><span class="line">... ...       &#123; role: &quot;readWrite&quot;, db: &quot;test&quot; &#125;</span><br><span class="line">... ...    ]</span><br><span class="line">... ...  &#125;</span><br><span class="line">... ... )</span><br><span class="line">Successfully added user: &#123;</span><br><span class="line">    &quot;user&quot; : &quot;test1&quot;,</span><br><span class="line">    &quot;roles&quot; : [</span><br><span class="line">        &#123;</span><br><span class="line">            &quot;role&quot; : &quot;readWrite&quot;,</span><br><span class="line">            &quot;db&quot; : &quot;test&quot;</span><br><span class="line">        &#125;</span><br><span class="line">    ]</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></li><li><p>验证 test1 账号是否添加成功，返回 1 表示验证成功</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">&gt; use test</span><br><span class="line">&gt; db.auth(&apos;test1&apos;, &apos;test1&apos;)</span><br><span class="line">1</span><br></pre></td></tr></table></figure></li><li><p>CentOS 开机启动，找到 /etc/rc.local，将下面这句话加入</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">/usr/local/mongodb3/bin/mongod --config /usr/local/mongodata/mongo.conf</span><br></pre></td></tr></table></figure></li><li><p>最后，需要在阿里云的控制台中找到安全组规则配置页面，将 27017 端口开放</p><p><img src="https://silencewanghui.github.io/images/部署02.png" alt="部署02"></p><p>推荐一款比较好用 MongoDB 客户端，<a href="https://mongobooster.com/" target="_blank" rel="noopener">mongobooster</a></p></li></ol><h4 id="Nginx-安装"><a href="#Nginx-安装" class="headerlink" title="Nginx 安装"></a>Nginx 安装</h4><ol><li><p>进入 /etc/yum.repos.d/，创建文件 nginx.repo</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">cd /etc/yum.repos.d</span><br><span class="line">vi nginx.repo</span><br><span class="line">将下面的内容写入到 nginx.repo</span><br><span class="line">[nginx]</span><br><span class="line">name=nginx repo</span><br><span class="line">baseurl=http://nginx.org/packages/centos/$releasever/$basearch/</span><br><span class="line">gpgcheck=0</span><br><span class="line">enabled=1</span><br></pre></td></tr></table></figure></li><li><p>安装</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">yum install nginx</span><br></pre></td></tr></table></figure></li><li><p>安装完成之后，执行如下命令查看安装位置</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">[root@iz2ze2pp5x5s9w6jcr1ndxz /]# whereis nginx</span><br><span class="line">nginx: /usr/sbin/nginx /usr/lib64/nginx /etc/nginx /usr/share/nginx /usr/share/man/man8/nginx.8.gz</span><br></pre></td></tr></table></figure></li><li><p>配置反向代理</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">vi /etc/nginx/nginx.conf</span><br></pre></td></tr></table></figure><p>将配置文件中的 server 选项如下配置</p><p><img src="https://silencewanghui.github.io/images/部署03.png" alt="部署03"></p><p>这里监听的是默认端口 80，你也可以改成其他端口，不过切记，如果是云服务器的网络是专有网络，一定要在阿里云控制台配置对应端口的安全组规则。</p></li><li><p>开放防火墙中的某些端口</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">#查看所有打开的端口</span><br><span class="line">firewall-cmd --zone=public --list-ports</span><br></pre></td></tr></table></figure><p><img src="https://silencewanghui.github.io/images/部署04.png" alt="部署04"></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">#加入一个端口到区域</span><br><span class="line">firewall-cmd --zone=public --add-port=80/tcp --permanent</span><br><span class="line">firewall-cmd --zone=public --add-port=27017/tcp --permanent</span><br><span class="line">#加上 --permanent 表示永久生效，否则在服务器重启后改规则失效</span><br></pre></td></tr></table></figure></li><li><p>常用命令</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">/usr/sbin/nginx #启动Nginx服务</span><br><span class="line">/usr/sbin/nginx -s stop #关闭Nginx服务</span><br><span class="line">/usr/sbin/nginx -t #检测Nginx的配置文件是否正确</span><br><span class="line">/usr/sbin/nginx -s reload #重启Nginx服务</span><br><span class="line">/etc/nginx/nginx.conf #Nginx配置文件位置</span><br></pre></td></tr></table></figure></li></ol><h2 id="3-总结"><a href="#3-总结" class="headerlink" title="3. 总结"></a>3. 总结</h2><p>至此，如果不出什么意外的话，Node + MongoDB + Nginx 的环境应该就部署好了，在此作为一个记录，也希望能够帮助到有此需求的朋友。</p><h2 id="4-参考文章"><a href="#4-参考文章" class="headerlink" title="4. 参考文章"></a>4. 参考文章</h2><ol><li>[<a href="https://segmentfault.com/a/1190000004051670" target="_blank" rel="noopener">把 Node.js 项目部署到阿里云服务器（CentOs）</a></li><li><a href="http://www.jianshu.com/p/c09342b7f64c" target="_blank" rel="noopener">centos6.5 部署 mongodb 3 安装配置</a></li><li><a href="https://github.com/dwqs/blog/issues/6" target="_blank" rel="noopener">Node+React 小爬虫：从开发到部署</a></li><li>[<a href="http://www.cnblogs.com/hantianwei/p/5736278.html" target="_blank" rel="noopener">Centos 7 防火墙 firewalld 开放 80 端口</a>]</li></ol>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;1-部署环境&quot;&gt;&lt;a href=&quot;#1-部署环境&quot; class=&quot;headerlink&quot; title=&quot;1. 部署环境&quot;&gt;&lt;/a&gt;1. 部署环境&lt;/h2&gt;&lt;p&gt;我是在阿里云上买的专有网络的云服务器，配置是：CPU 1 核，内存 1GB，操作系统 CentOS 7.3 64 位，带宽 1Mbps。配置很低，因为便宜嘛，平时自己的一些小 demo 够了。以下的部署步骤基于此环境。&lt;/p&gt;
&lt;p&gt;之前部署过几次，都是在网络上东找找西找找的配置文章，本身对于服务器相关的知识一窍不通，因此配置完了也就忘了。最近刚在这台新服务器上部署了 Node 的运行环境，借此记录下步骤，以便日后查找，也给有需要的朋友一些参考价值。&lt;/p&gt;
    
    </summary>
    
    
      <category term="Node.js" scheme="http://silencewh.xin/tags/Node-js/"/>
    
  </entry>
  
  <entry>
    <title>防抖动、节流阀与rAF</title>
    <link href="http://silencewh.xin/2017/06/19/%E9%98%B2%E6%8A%96%E5%8A%A8%E3%80%81%E8%8A%82%E6%B5%81%E9%98%80%E4%B8%8ErAF/"/>
    <id>http://silencewh.xin/2017/06/19/防抖动、节流阀与rAF/</id>
    <published>2017-06-19T14:57:18.000Z</published>
    <updated>2019-11-27T10:24:33.414Z</updated>
    
    <content type="html"><![CDATA[<h4 id="1-简介"><a href="#1-简介" class="headerlink" title="1.简介"></a>1.简介</h4><p>在 web 开发中，经常会对一些事件进行监听处理，从而达到我们需要的一些效果。但是某些事件触发特别频繁，如浏览器窗口的 resize 事件以及页面的滚动事件。如此频繁的事件监听以及处理函数的多次执行，势必会带来性能上不必要的损失和欠佳的用户体验。</p><p>因此，今天就初探一下类似问题的解决办法：防抖动（Debounce ）、节流阀（Throttle）和 requestAnimationFrame。</p><a id="more"></a><h4 id="2-防抖动（Debounce）"><a href="#2-防抖动（Debounce）" class="headerlink" title="2.防抖动（Debounce）"></a>2.防抖动（Debounce）</h4><p>简单来说，防抖动技术就是把触发非常频繁的事件合并成一次执行。</p><p>先看一下代码实例：</p><figure class="highlight javascript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">function</span> <span class="title">debounce</span>(<span class="params">func, wait</span>) </span>&#123;</span><br><span class="line">  <span class="keyword">var</span> timeID = <span class="literal">null</span>;</span><br><span class="line">  <span class="keyword">return</span> <span class="function"><span class="keyword">function</span>(<span class="params"></span>) </span>&#123;</span><br><span class="line">    <span class="comment">// 首先是清空定时器</span></span><br><span class="line">    clearTimeout(timeID);</span><br><span class="line">    <span class="comment">// 延迟 wait ms后执行真正的事件处理函数</span></span><br><span class="line">    timeID = setTimeOut(func, wait);</span><br><span class="line">  &#125;;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">function</span> <span class="title">hanlder</span>(<span class="params"></span>) </span>&#123;</span><br><span class="line">  <span class="built_in">console</span>.log(<span class="string">"Hanlde the scroll event."</span>);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="built_in">window</span>.addEventListener(<span class="string">"scroll"</span>, debounce(hanlder, <span class="number">400</span>));</span><br></pre></td></tr></table></figure><p>简要解释一下，如果在 400ms 内连续触发 scroll 事件，那么真正的事件处理是不会执行的。只有当快速的事件触发停止以后，处理函数才会执行，也就是说 debounce 函数将多次的事件触发合并成了一次。</p><h4 id="3-节流阀（Throttle）"><a href="#3-节流阀（Throttle）" class="headerlink" title="3.节流阀（Throttle）"></a>3.节流阀（Throttle）</h4><p>节流函数，只允许一个函数在规定的时间内执行一次。</p><p>它和防抖动最大的区别就是，节流函数是不管事件触发有多频繁，都会保证在规定事件内必须执行一次真正的事件处理函数。因此，有些场景下，就不能够使用防抖动技术，转而用节流阀代替。</p><p>比如在页面的无限加载场景下，我们需要用户在滚动页面时，每隔一段时间发一次 Ajax 请求，而不是在用户停下滚动页面操作时才去请求数据。这样的场景，就适合用节流阀技术来实现。代码实例如下：</p><figure class="highlight javascript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">var</span> throttle = <span class="function"><span class="keyword">function</span>(<span class="params">func, wait</span>) </span>&#123;</span><br><span class="line">  <span class="keyword">var</span> timeout,</span><br><span class="line">    context,</span><br><span class="line">    args,</span><br><span class="line">    startTime = <span class="built_in">Date</span>.parse(<span class="keyword">new</span> <span class="built_in">Date</span>());</span><br><span class="line"></span><br><span class="line">  <span class="keyword">return</span> <span class="function"><span class="keyword">function</span>(<span class="params"></span>) </span>&#123;</span><br><span class="line">    <span class="keyword">var</span> curTime = <span class="built_in">Date</span>.parse(<span class="keyword">new</span> <span class="built_in">Date</span>());</span><br><span class="line">    <span class="keyword">var</span> remaining = wait - (curTime - startTime);</span><br><span class="line">    context = <span class="keyword">this</span>;</span><br><span class="line">    args = <span class="built_in">arguments</span>;</span><br><span class="line"></span><br><span class="line">    clearTimeout(timeout);</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> (remaining &lt;= <span class="number">0</span>) &#123;</span><br><span class="line">      func.apply(context, args);</span><br><span class="line">      startTime = <span class="built_in">Date</span>.parse(<span class="keyword">new</span> <span class="built_in">Date</span>());</span><br><span class="line">    &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">      timeout = setTimeout(func, remaining);</span><br><span class="line">    &#125;</span><br><span class="line">  &#125;;</span><br><span class="line">&#125;;</span><br></pre></td></tr></table></figure><h4 id="4-requestAnimationFrame"><a href="#4-requestAnimationFrame" class="headerlink" title="4.requestAnimationFrame"></a>4.requestAnimationFrame</h4><blockquote><p><strong>window.requestAnimationFrame() </strong>方法告诉浏览器您希望执行动画，并请求浏览器调用指定的函数在下一次重绘之前更新动画。该方法将在重绘之前调用的回调作为参数。</p><p>如果你想做逐帧动画的时候，你应该用这个方法。这就要求你的动画函数执行会先于浏览器重绘动作。通常来说，被调用的频率是每秒 60 次，但是一般会遵循 W3C 标准规定的频率。如果是后台标签页面，重绘频率则会大大降低。</p></blockquote><p>代码实例：</p><figure class="highlight javascript"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">function</span> <span class="title">update</span>(<span class="params">timeStamp</span>)</span>&#123;</span><br><span class="line">  <span class="comment">// 执行动画一帧所需要的计算工作</span></span><br><span class="line">  ...</span><br><span class="line">&#125;</span><br><span class="line">requestAnimationFrame(update)</span><br></pre></td></tr></table></figure><p>回调函数会被传入一个时间戳作为参数，该参数指示出回调函数将被触发的时间。</p><p>简单来说 rAF 会在浏览器渲染的下一帧执行动画所需的计算操作，而且执行的频率与显示器的刷新率保持一致，</p><p>这样就避免了我们使用定时器时由于指定的间隔时间太长或太短引起的动画掉帧或卡顿的问题。</p><p>浏览器兼容方面，IE 10.0 及以上支持。</p><h4 id="5-总结"><a href="#5-总结" class="headerlink" title="5.总结"></a>5.总结</h4><p>第一次写博客，自我感觉对于技术的剖析很浅，没有达到自己理想的效果。慢慢来吧，再接再厉，参考文章列表里的都是一些非常优秀的文章，大家可以仔细阅读。</p><h3 id="参考文章"><a href="#参考文章" class="headerlink" title="参考文章"></a>参考文章</h3><ol><li><a href="https://github.com/chokcoco/cnblogsArticle/issues/12" target="_blank" rel="noopener">【前端性能】高性能滚动 scroll 及页面渲染优化</a></li><li><a href="http://jinlong.github.io/2016/04/24/Debouncing-and-Throttling-Explained-Through-Examples/" target="_blank" rel="noopener">实例解析防抖动（Debouncing）和节流阀（Throttling）</a></li><li><a href="http://www.infoq.com/cn/articles/javascript-high-performance-animation-and-page-rendering" target="_blank" rel="noopener">Javascript 高性能动画与页面渲染</a></li></ol>]]></content>
    
    <summary type="html">
    
      &lt;h4 id=&quot;1-简介&quot;&gt;&lt;a href=&quot;#1-简介&quot; class=&quot;headerlink&quot; title=&quot;1.简介&quot;&gt;&lt;/a&gt;1.简介&lt;/h4&gt;&lt;p&gt;在 web 开发中，经常会对一些事件进行监听处理，从而达到我们需要的一些效果。但是某些事件触发特别频繁，如浏览器窗口的 resize 事件以及页面的滚动事件。如此频繁的事件监听以及处理函数的多次执行，势必会带来性能上不必要的损失和欠佳的用户体验。&lt;/p&gt;
&lt;p&gt;因此，今天就初探一下类似问题的解决办法：防抖动（Debounce ）、节流阀（Throttle）和 requestAnimationFrame。&lt;/p&gt;
    
    </summary>
    
    
      <category term="JavaScript" scheme="http://silencewh.xin/tags/JavaScript/"/>
    
  </entry>
  
  <entry>
    <title>First One</title>
    <link href="http://silencewh.xin/2017/06/08/First-One/"/>
    <id>http://silencewh.xin/2017/06/08/First-One/</id>
    <published>2017-06-07T16:18:28.000Z</published>
    <updated>2017-06-07T08:19:16.000Z</updated>
    
    <content type="html"><![CDATA[<p>博客初始搭建完成，以后会在这里写一些技术上的知识学习以及工作中的踩坑记录。<br>Keep Moving.</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;博客初始搭建完成，以后会在这里写一些技术上的知识学习以及工作中的踩坑记录。&lt;br&gt;Keep Moving.&lt;/p&gt;


    </summary>
    
    
      <category term="随笔" scheme="http://silencewh.xin/tags/%E9%9A%8F%E7%AC%94/"/>
    
  </entry>
  
</feed>